Como identificar problemas de latência de disco no SQL Server
Fala galera!
Hoje vamos mergulhar em um dos problemas mais comuns e muitas vezes ignorados que podem sabotar a performance do seu SQL Server. A famosa “Latência de disco”.
Se você já se perguntou por que suas consultas estão lentas mesmo com índices otimizados, ou por que o servidor parece “engasgar” do nada, este artigo é para você. Vou mostrar como identificar, diagnosticar e resolver problemas de latência de disco usando as ferramentas que o próprio SQL Server nos oferece.
O que é latência de disco e por que ela importa tanto?
Latência de disco é o tempo que o SQL Server precisa esperar para que uma operação de I/O (leitura ou escrita) seja completada pelo subsistema de armazenamento. Em outras palavras, é quanto tempo seus dados “demoram para chegar” quando o SQL Server pede por eles.
Por que isso é crítico?
- SQL Server é extremamente dependente de IO
- Dados e logs precisam ser lidos/escritos constantemente
- Cada milissegundo conta quando falamos de performance
- Uma latência alta pode causar timeout de consultas
Segundo a documentação da Microsoft, aqui estão os valores que devemos ter como referência:
- < 10-15ms – Aceitável para a maioria dos workloads
- < 2ms – Excelente (SSD/NVMe)
- > 20ms – Atenção – possível problema
- > 50ms – Problema sério de I/O
Conhecendo a DMV sys.dm_io_virtual_file_stats
Desde 2005, a Microsoft nos deu uma ferramenta poderosa para monitorar IO. A DMV “sys.dm_io_virtual_file_stats“. Essa belezinha coleta estatísticas desde o último restart do SQL Server e é nossa principal aliada para esse tipo de diagnóstico.
Aqui está minha versão da query de diagnóstico, com classificação dos resultados
-- Análise completa de latência de disco
-- Baseado em sys.dm_io_virtual_file_stats
SELECT
    DB_NAME(vfs.database_id) AS [Database],
    mf.physical_name AS [Arquivo_Fisico],
    LEFT(mf.physical_name, 2) AS [Drive],
    mf.type_desc AS [Tipo_Arquivo],

    -- Latências calculadas
    CASE WHEN vfs.num_of_reads =0
         THEN 0
         ELSE (vfs.io_stall_read_ms / vfs.num_of_reads)
    END AS [Latencia_Leitura_ms],

    CASE WHEN vfs.num_of_writes =0
         THEN 0
         ELSE (vfs.io_stall_write_ms / vfs.num_of_writes)
    END AS [Latencia_Escrita_ms],

    CASE WHEN (vfs.num_of_reads = 0 AND vfs.num_of_writes = 0)
         THEN 0
         ELSE (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes))
    END AS [Latencia_Total_ms],

    -- Classificação automática
    CASE
        WHEN (vfs.num_of_reads =0 AND vfs.num_of_writes =0) THEN 'Sem Dados'
        WHEN (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)) < 2 THEN 'Excelente'
        WHEN (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)) < 6 THEN 'Muito Bom'
        WHEN (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)) < 11 THEN 'Bom'
        WHEN (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)) < 21 THEN 'Ruim'
        WHEN (vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)) < 101 THEN 'Muito Ruim'
        ELSE 'Crítico'
    END AS [Status_Performance],

    -- Estatísticas de uso
    vfs.num_of_reads AS [Total_Leituras],
    vfs.num_of_writes AS [Total_Escritas],

    -- Throughput médio
    CASE WHEN vfs.num_of_reads =0
         THEN 0
         ELSE (vfs.num_of_bytes_read / vfs.num_of_reads / 1024)
    END AS [KB_por_Leitura],

    CASE WHEN vfs.num_of_writes =0
         THEN 0
         ELSE (vfs.num_of_bytes_written / vfs.num_of_writes / 1024)
    END AS [KB_por_Escrita],

    -- Tamanho do arquivo
    (mf.size * 8) / 1024 AS [Tamanho_MB]

FROM sys.dm_io_virtual_file_stats(NULL, NULL) AS vfs
JOIN sys.master_files AS mf
    ON vfs.database_id = mf.database_id
    AND vfs.file_id = mf.file_id
WHERE DB_NAME(vfs.database_id) IS NOT NULL
ORDER BY [Latencia_Total_ms] DESC;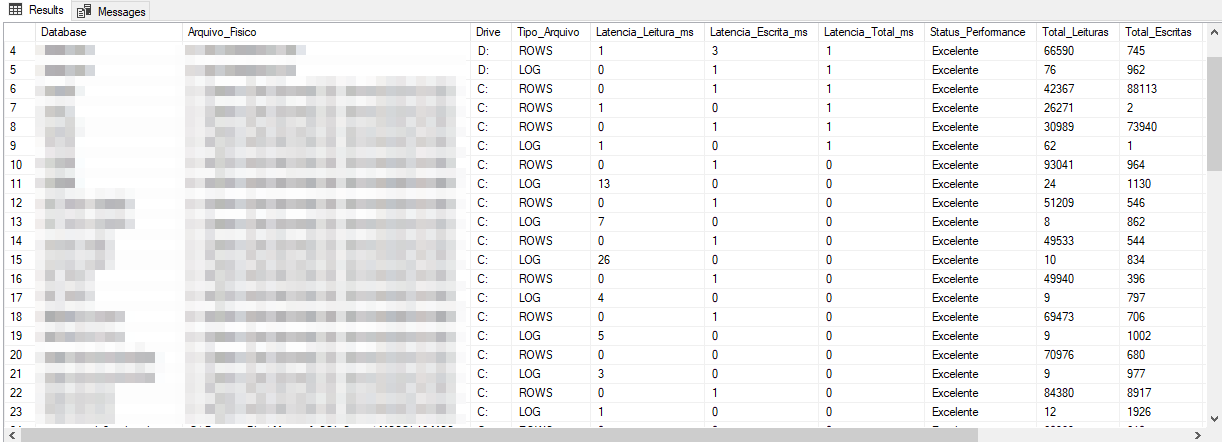
Interpretando os Resultados
Excelente (< 2ms)
Parabéns! Seu storage está voando. Provavelmente usando SSD ou NVMe com configuração adequada.
Muito Bom (2-5ms)
Performance sólida. Pode ser SSD mais antigo ou configuração bem otimizada de storage tradicional.
Bom (6-10ms)
Ainda aceitável, mas fique de olho. Pode ser hora de planejar um upgrade.
Ruim (11-20ms)
Atenção necessária. Já está impactando performance. Investigue:
- Configurações da storage
- Gargalos de hardware
- Concorrência de I/O
Muito Ruim (21-100ms)
Problema sério! Usuários já estão sentindo o impacto. Ação imediata necessária.
Crítico (> 100ms)
Emergência! Performance inaceitável. Investigação urgente do subsistema de storage.
Script para análise por Drive
Muitas vezes queremos ver o comportamento geral por drive:
-- Análise de latência por drive
SELECT
    LEFT(mf.physical_name, 2) AS [Drive],
    COUNT(*) AS [Arquivos_no_Drive],
    -- Somatórias por drive
    SUM(vfs.num_of_reads) AS [Total_Leituras],
    SUM(vfs.num_of_writes) AS [Total_Escritas],
    SUM(vfs.io_stall_read_ms) AS [Total_Stall_Leitura_ms],
    SUM(vfs.io_stall_write_ms) AS [Total_Stall_Escrita_ms],
    SUM(vfs.io_stall) AS [Total_Stall_ms],

    -- Latências médias calculadas
    CASE WHEN SUM(vfs.num_of_reads) =0
         THEN 0
         ELSE SUM(vfs.io_stall_read_ms) / SUM(vfs.num_of_reads)
    END AS [Latencia_Media_Leitura_ms],

    CASE WHEN SUM(vfs.num_of_writes) =0
         THEN 0
         ELSE SUM(vfs.io_stall_write_ms) / SUM(vfs.num_of_writes)
    END AS [Latencia_Media_Escrita_ms],

    CASE WHEN (SUM(vfs.num_of_reads) +SUM(vfs.num_of_writes)) =0
         THEN 0
         ELSE SUM(vfs.io_stall) / (SUM(vfs.num_of_reads) + SUM(vfs.num_of_writes))
    END AS [Latencia_Media_Total_ms],

    -- Status do drive
    CASE
        WHEN (SUM(vfs.num_of_reads) + SUM(vfs.num_of_writes)) = 0 THEN 'Sem Atividade'
        WHEN SUM(vfs.io_stall) / (SUM(vfs.num_of_reads) + SUM(vfs.num_of_writes)) < 5 THEN 'Ótimo'
        WHEN SUM(vfs.io_stall) / (SUM(vfs.num_of_reads) + SUM(vfs.num_of_writes)) < 15 THEN 'Bom'
        WHEN SUM(vfs.io_stall) / (SUM(vfs.num_of_reads) + SUM(vfs.num_of_writes)) < 25 THEN 'Atenção'
        ELSE 'Problema'
    END AS [Status_Drive]

FROM sys.dm_io_virtual_file_stats(NULL, NULL) AS vfs
JOIN sys.master_files AS mf
    ON vfs.database_id = mf.database_id
    AND vfs.file_id = mf.file_id
WHERE DB_NAME(vfs.database_id) IS NOT NULL
GROUP BY LEFT(mf.physical_name, 2)
ORDER BY [Latencia_Media_Total_ms] DESC;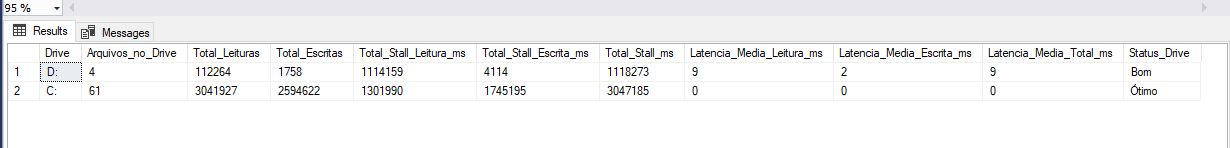
Diagnosticando Queries com IO Alto
Às vezes o problema não está no hardware, mas sim em queries específicas que estão gerando muito IO (Leituras). Aqui está um script para identificar essas queries:
-- Top 20 queries por I/O físico (leituras de disco)
SELECT TOP 20
    qs.execution_count AS [Execuções],
    qs.total_physical_reads AS [Leituras_Fisicas_Total],
    qs.total_physical_reads / qs.execution_count AS [Leituras_Fisicas_Media],
    qs.total_logical_reads AS [Leituras_Logicas_Total],
    qs.total_logical_writes AS [Escritas_Logicas_Total],
    qs.last_execution_time AS [Ultima_Execução],

    -- Texto da query (resumido)
    SUBSTRING(st.text, (qs.statement_start_offset/2)+1,
        ((CASE qs.statement_end_offset
            WHEN -1 THEN DATALENGTH(st.text)
            ELSE qs.statement_end_offset
        END - qs.statement_start_offset)/2) + 1) AS [Query_Text],

    -- Tempos de execução
    qs.total_elapsed_time / 1000 AS [Tempo_Total_ms],
    (qs.total_elapsed_time / qs.execution_count) / 1000 AS [Tempo_Medio_ms],

    -- Plan handle para investigações futuras
    qs.plan_handle

FROM sys.dm_exec_query_stats qs
CROSS APPLY sys.dm_exec_sql_text(qs.plan_handle) st
WHERE qs.total_physical_reads > 0
ORDER BY qs.total_physical_reads DESC;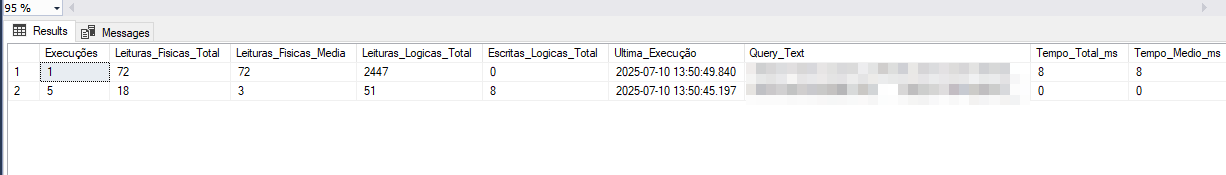
Monitoramento em Tempo Real com Wait Stats
Para uma visão em tempo real dos problemas de IO, podemos visualizar a partir dos eventos de espera (waits stats) :
-- Wait stats relacionadas a I/O
-- Execute este script algumas vezes para ver tendências
SELECT
    wait_type AS [Tipo_Espera],
    waiting_tasks_count AS [Tarefas_Esperando],
    wait_time_ms AS [Tempo_Espera_ms],
    max_wait_time_ms AS [Tempo_Max_ms],
    signal_wait_time_ms AS [Tempo_Sinal_ms],

    -- Tempo médio de espera
    CASE
        WHEN waiting_tasks_count >0
        THEN wait_time_ms / waiting_tasks_count
        ELSE 0
    END AS [Tempo_Medio_Espera_ms],

    -- Classificação do problema
    CASE
        WHEN wait_type LIKE 'PAGEIOLATCH%' THEN 'Leitura de Páginas'
        WHEN wait_type = 'WRITELOG' THEN 'Escrita de Log'
        WHEN wait_type LIKE 'IO_COMPLETION' THEN 'IO Geral'
        WHEN wait_type LIKE 'ASYNC_IO_COMPLETION' THEN 'IO Assíncrono'
        ELSE 'Outro IO'
    END AS [Categoria]

FROM sys.dm_os_wait_stats
WHERE wait_type IN (
    'PAGEIOLATCH_SH',
    'PAGEIOLATCH_EX',
    'PAGEIOLATCH_UP',
    'WRITELOG',
    'IO_COMPLETION',
    'ASYNC_IO_COMPLETION',
    'BACKUPIO'
)
AND waiting_tasks_count > 0
ORDER BY wait_time_ms DESC;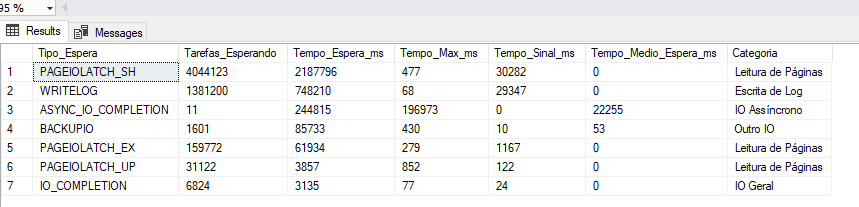
Dicas práticas para melhorar a performance do seu ambiente
Separação de Arquivos
- Separe os arquivos de Dados e Logs em discos diferentes no seu servidor (Veja bem, eu disse : Discos diferentes, se estiverem virtualizados no mesmo storage, talvez não valha a pena, ou valha no caso de querer manter as labels separadas por questões de organização).
- Coloque o TempDB provisionado em drive separado (preferencialmente SSD)
- Backups em storage separado
Configuração de Hardware
- Use SSD para logs de transação
- Configure RAID 10 para dados críticos
- RAID 1 para logs (performance sequencial)
Script de Diagnóstico Completo
Para finalizar, aqui está um script que faz uma análise completa do seu ambiente:
-- DIAGNÓSTICO COMPLETO DE LATÊNCIA DE DISCO
-- Execute este script para uma visão geral do seu ambiente
\
PRINT '==========================================';
PRINT 'DIAGNÓSTICO DE LATÊNCIA DE DISCO';
PRINT 'Executado em: ' + CAST(GETDATE() AS VARCHAR(20));
PRINT '==========================================';

-- 1. Resumo geral por database
PRINT CHAR(13) + '1. RESUMO POR DATABASE:';
SELECT
    DB_NAME(vfs.database_id) AS [Database],
    COUNT(*) AS [Arquivos],

    CASEWHENSUM(vfs.num_of_reads + vfs.num_of_writes) =0
         THEN0
         ELSE SUM(vfs.io_stall) / SUM(vfs.num_of_reads + vfs.num_of_writes)
    END AS [Latencia_Media_ms],

    CASE
        WHEN SUM(vfs.num_of_reads + vfs.num_of_writes) = 0 THEN 'Sem Dados'
        WHEN SUM(vfs.io_stall) / SUM(vfs.num_of_reads + vfs.num_of_writes) < 5 THEN 'Ótimo'
        WHEN SUM(vfs.io_stall) / SUM(vfs.num_of_reads + vfs.num_of_writes) < 15 THEN 'Bom'
        WHEN SUM(vfs.io_stall) / SUM(vfs.num_of_reads + vfs.num_of_writes) < 25 THEN 'Atenção'
        ELSE 'Problema'
    END AS [Status]

FROM sys.dm_io_virtual_file_stats(NULL, NULL) vfs
WHERE DB_NAME(vfs.database_id) IS NOT NULL
GROUP BY vfs.database_id
ORDER BY [Latencia_Media_ms] DESC;

-- 2. Top 5 arquivos com maior latência
PRINT CHAR(13) + '2. TOP 5 ARQUIVOS COM MAIOR LATÊNCIA:';
SELECT TOP 5
    DB_NAME(vfs.database_id) AS [Database],
    mf.physical_name AS [Arquivo],

    CASE WHEN (vfs.num_of_reads + vfs.num_of_writes) =0
         THEN 0
         ELSE vfs.io_stall / (vfs.num_of_reads + vfs.num_of_writes)
    END AS [Latencia_ms],

    mf.type_desc AS [Tipo]

FROM sys.dm_io_virtual_file_stats(NULL, NULL) vfs
JOIN sys.master_files mf ON vfs.database_id = mf.database_id AND vfs.file_id = mf.file_id
WHERE DB_NAME(vfs.database_id) IS NOT NULL
  AND (vfs.num_of_reads + vfs.num_of_writes) > 0
ORDER BY [Latencia_ms] DESC;

-- 3. Wait stats de I/O atual
PRINT CHAR(13) + '3. WAIT STATS DE I/O MAIS RELEVANTES:';
SELECT TOP 5
    wait_type,
    waiting_tasks_count,
    wait_time_ms,
    CASE
        WHEN waiting_tasks_count >0
        THEN wait_time_ms / waiting_tasks_count
        ELSE 0
    END AS [Tempo_Medio_ms]
FROM sys.dm_os_wait_stats
WHERE wait_type IN ('PAGEIOLATCH_SH', 'PAGEIOLATCH_EX', 'WRITELOG', 'IO_COMPLETION')
  AND waiting_tasks_count > 0
ORDER BY wait_time_ms DESC;

PRINT CHAR(13) + '==========================================';
PRINT 'DIAGNÓSTICO CONCLUÍDO';
PRINT '==========================================';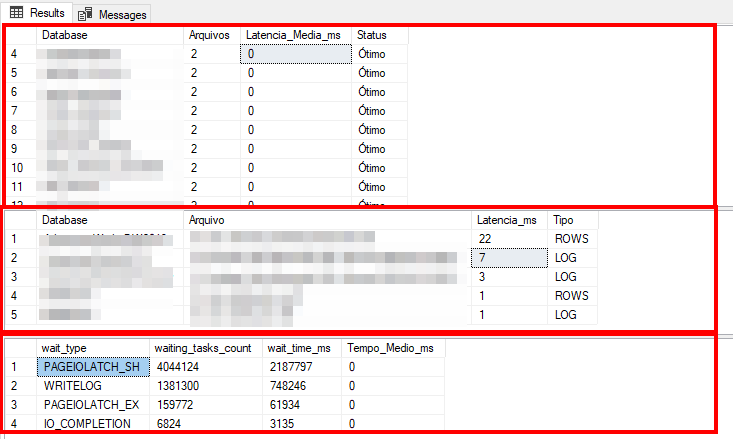
Conclusão
Latência de disco não é só um número técnico, é um indicador direto da experiência do usuário com seu sistema. Uma latência alta significa:
- Timeouts de aplicação
- Lentidão perceptível pelos usuários
- Degradação geral da performance
- Possíveis perdas de produtividade em virtude da lentidão
Acompanhe sempre de perto os indicadores do disco, eles dizem muito sobre a saúde do seu ambiente.
E você? Já enfrentou problemas de latência de disco? Qual foi a solução que funcionou no seu ambiente?
Compartilhe sua experiência nos comentários!
Gustavo Larocca
Consultor SQL Server
—
Referências:
– [Microsoft Docs – Troubleshoot slow SQL Server performance caused by I/O issues](https://learn.microsoft.com/en-us/troubleshoot/sql/database-engine/performance/troubleshoot-sql-io-performance)
– [Microsoft Docs – sys.dm_io_virtual_file_stats](https://learn.microsoft.com/en-us/sql/relational-databases/system-dynamic-management-views/sys-dm-io-virtual-file-stats-transact-sql)
Gostou do conteúdo?
Acompanhe novos artigos sobre SQL Server, performance e administração de banco de dados.